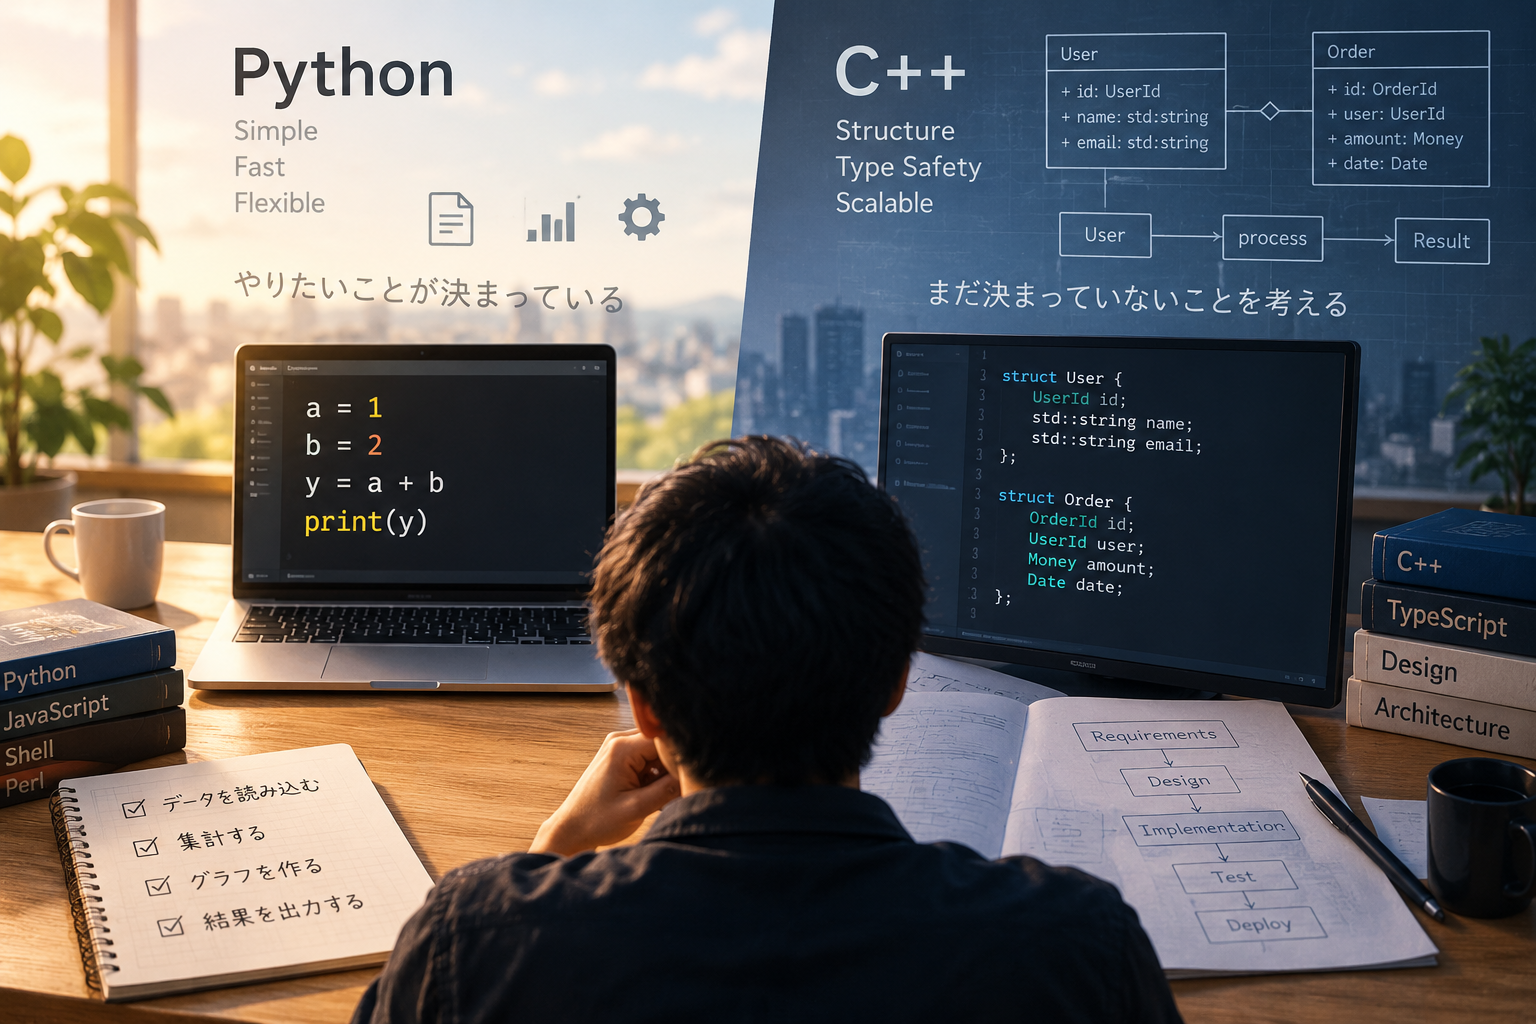
Pythonを開いて、「さて、何を作ろう」と考えたとき、不思議と手が止まることがあります。
ところがC++では、作るものが決まっていなくても何となく書き始められます。
最初は単なる慣れの違いだと思っていました。
しかし考えていくと、これは動的型付けと静的型付けが、プログラマの思考に与える違いなのではないかと思うようになりました。
Pythonは目的が決まると強い
たとえば、「2つの値を足したい」と決まっているなら、Pythonではすぐに書けます。
a = 1
b = 2
y = a + b
型を書く必要も、main()を用意する必要もありません。
CSVを集計したい、ファイルを変換したい、APIを呼びたい。
このように目的と扱うデータが決まっている場合、書かなくていいものが多いPythonはとても強いと感じます。
しかし、「何を作るかはまだ分からない。書きながら考えたい」となると、少し事情が変わります。
C++では値がなくても考え始められる
C++なら、
int a;
int b;
int y;
と書けます。
まだ具体的な値は決まっていません。
それでも、「3つの整数を使う」という構造だけは決まりました。
そこから頭の中で、
y = a + b
という関係を考えることもできます。
実際には未初期化のaとbを計算に使ってはいけません。ここで重要なのは、具体的な値がなくても関係を考え始められることです。
int a;
は、
「aにどんな値を与えるかはまだ決めていない。しかし整数として扱うことは決めた」
という状態でもあります。
つまり、
何も決まっていない
        ↓
型を決める
        ↓
関係を決める
        ↓
具体的な値や実装を決める
と、少しずつ具体化できます。
型宣言は、抽象から具体へ進むための思考の足場にもなっているわけです。
「書かなくていい」ことで消える工程もある
Pythonでは、
a = 1
と、具体的な値からすぐ始められます。
これは目的が決まっているときには大きなメリットです。
一方で、
型を考える
↓
変数を用意する
↓
値を決める
という途中の工程を飛ばすこともできます。
「書かなくていい」ということは、「書くことで考える工程を省略できる」ということでもあります。
もちろんPythonでも、
def add(a: int, b: int) -> int:
    return a + b
のように抽象から始められますし、
a: int
のように値なしの型注釈を書くこともできます。
ただし、C++の変数宣言とは意味が異なり、Pythonを書くうえで必須の工程でもありません。
Pythonが抽象化できないのではなく、抽象から始めることを言語が強く要求しないところに違いがあります。
型は機械のためだけに書いているのか
型については、
「コンパイラに、この値をどのように扱うか伝えるために書く」
と説明されることがあります。
もちろん、型はコンパイラによる検査やコード生成にも使われます。
しかし、それだけでしょうか。
たとえば、
User findUser(UserId id);
と書いてあれば、人間は実装を読まなくても、
UserId
  ↓
findUser
  ↓
User
という関係を理解できます。
さらに、
class User;
class Order;

Order createOrder(const User&);
と書けば、具体的なUserやOrderのオブジェクトがまだ存在しない段階から、システムの構造を考えられます。
ここでは型が、単にコンパイラへ情報を伝えるものではなく、人間がプログラムの世界を理解するための語彙として働いています。
実行する処理そのものではない記述でも、人間にとっては重要な思考の手掛かりになります。
そう考えると、型を書くという行為は、
コンパイラに型を伝える
だけではなく、
曖昧な考え
    ↓
型として名前を付ける
    ↓
型同士の関係を書く
    ↓
実装する
という、人間自身が考えを整理する工程でもあるのかもしれません。
大きなプログラムほど「まだ決まっていない」が増える
この違いを考えると、大きなプログラムで静的型付けに安心感を覚える理由も見えてきます。
小さなプログラムでは、
このファイルを読む
↓
集計する
↓
結果を出す
のように、目的が明確なことが多くあります。
一方、大きなプログラムでは全体の目的が決まっていても、
Userとは何か
Orderとは何か
IDをどう表現するか
どの処理が何を受け取るか
何を返すか
など、細部には未確定な部分が大量にあります。
そこで型を使えば、
struct User {
    UserId id;
    std::string name;
};

struct Order {
    OrderId id;
    UserId user;
};
と、具体的なデータがなくても構造を先に作れます。
決まっていないことが多いからこそ、決まったところだけを型として固定していく。
これはコンピュータのためだけではありません。
むしろ規模が大きくなるほど、プログラマ自身が「何が決まっていて、何が決まっていないのか」を把握するための道具として、型の価値が大きくなるのかもしれません。
JavaScriptよりTypeScriptが安心する理由
同じことはJavaScriptとTypeScriptにも当てはまりそうです。
JavaScriptなら、
function process(user) {
    // ...
}
TypeScriptなら、
function process(user: User): Result {
    // ...
}
と書けます。
具体的なuserも、処理の実装もまだ存在しません。
それでも、
User
 ↓
process
 ↓
Result
という構造だけは先に決められます。
大きなプログラムでTypeScriptを使うと安心するのは、単に型エラーを発見できるからだけではなく、まだ完成していないシステムを、人間が理解できる形で少しずつ組み立てられるからなのかもしれません。
型は「思考の足場」でもある
動的型付けは、目的が明確なときには非常に強力です。
具体的な値からすぐに処理を書き始められます。
一方、静的型付けでは、まだ具体的な値や実装が決まっていなくても、分かっていることだけを型として先に表現できます。
まだ分からない
↓
分かっている型を決める
↓
関係を決める
↓
処理を決める
↓
具体化する
静的型付けは、単にプログラムを厳しくする仕組みではありません。
「まだ分からないものを、分かっているところから少しずつ形にする」ための道具にもなる。
Pythonを開いて「何をしよう」と迷い、C++を開くと「何とかなるかもしれない」と感じたことで、そのことに気づきました。
型を書くことは、コンピュータに情報を与えるだけではありません。
人間が複雑なプログラムを理解し、自分自身が考えるための足場を作ることでもあるのかもしれません。
コメント